目录
数据类型
数值
- rune是int32的别名(一般用来表示字符类型,其范围可以表示所有的Unicode编码,需要打印字符时要用%c作为占位符),byte是uint8的别名(存储的是字节值,可以用来存储和表示ASCII字符和处理二进制数据,如文件读写、网络通信等)。
- 当将一个整数转换为 byte 时,Go 会截取其低 8 位,并将其解释为无符号整数。(其它整数类型发生溢出时,行为也是相似的)
简便计算:byte类型的值,前面加负号,如
var a byte = 5,然后执行a = -a相当于a = byte(256 - int(a))的值,这样a的最终值为251。(底层原因是Go语言会将-5的补码 11111011 直接解释为无符号整数 251)
例如:
var b int8 = -128,然后执行fmt.Println(b==-b),结果为true,因为int8的范围是[-128,127],128会溢出。128 的二进制表示是 10000000 ,等于-128的补码,所以会被直接解释为-128。
-
有符号整数,其原码二进制最高位(最左边的位)通常用作符号位,0为正,1为负。
-
有符号整数,在现代计算机中通常用补码(最高位仍是符号位)表示(便于计算,可以直接通过加法实现减法运算,不存在双0问题),正整数的补码和原码一样,负整数的补码是其绝对值的原码各个位(包括符号位)取反后加1。
-
Go语言里面,八进制数以 0 开头,十六进制数以 0x 开头。
-
^在Go语言里面表示异或运算(相同为0,不同为1)
切片
切片的底层引用了数组,当切片截取了某个数组(也包括[0:0]),底层就会指向这个数组,除非append操作之后,超出原数组的容量范围,才会分配一个新的数组给切片作为底层。
数组和切片截取a[3:4:4],第一个为起始位置,第二个是截取结束位置,第三个是容量位置。
截取开始和截取结束位置可以大于长度位置,但必须小于等于容量位置。
容量位置必须大于或等于截取结束位置。如果省略第二个参数,则默认第二个参数为len(a),如果省略第三个参数,则默认第三个参数为cap(a)。
如果仅仅是通过下标取值,而不是截取,注意下标位置必须小于切片长度
计算切片长度,可以直接用第二个位置的值,减去第一个位置的值;计算切片容量,可以直接用第三个位置的值,减去第一个位置的值。
切片只能和nil进行比较(即使是未赋值的空接口也不能比较)。
所有不可比较类型都是只能和nil比较
对于切片(包括空切片和nil切片),可以在其容量范围内进行截取,其中没有元素的地方会用零值填充。省略截取结束位置参数时,默认为切片长度值。
nil切片截取之后仍是nil
s=[]int{}与s=make([]int,0)得到是空切片,var s []int得到的是一个nil切片。空切片底层指向同一个全局的空数组,nil切片底层是一个空指针。
数组和切片中可以指定下标[]int{5:1, 2, 3, 1:9, 10},未指定下标的,下标为前一个指定下标的位置加一,即为[]int{5:1, 6:2, 7:3, 1:9, 2:10},剩余的位置补0
当切片作为函数形参的时候,传递参数的时候,是引用传递,实际上传递的是一个包含底层数组指针、切片长度、切片容量的结构体。这个结构体本身是按照值传递的。所以函数内部接收的是一个副本,只不过这个副本指向通用的底层数组,长度和容量字段都是副本自己的。所以当函数内部执行append函数时,实际是改变了函数内部副本变量的长度和容量。
切片为nil时,也可以进行截取操作,如[:],截取后也等于nil,也可以进行len()、cap()操作
不允许对切片指针进行索引,但是数组指针可以
copy(dst,src)函数会复制切片内容,但是不会改变切片地址和大小,返回值是len(dst)、len(src)中的最小值。
直接使用fmt.Printf("%p",s),打印的是切片s的地址,获取底层数组地址需要通过
&s[0]获取,如果切片指向一个空数组,则无法获取数组的地址。
切片扩容规则
append 超过容量时会分配新数组并拷贝旧数据,新容量按以下规则估算(Go 1.18 起):
- 如果原容量
oldCap < 256,新容量翻倍:newCap = oldCap * 2; - 如果
oldCap >= 256,按约 1.25 倍增长:newCap += (newCap + 3*256) >> 2,直到超过所需容量(早期版本是 1.25 倍,1.18 加入了 256 这个拐点,避免小切片增长过慢、大切片增长过猛); - 最后按内存分配器的 size class 向上取整,所以最终容量通常大于计算值(比如
append后 cap 常常是 384、512 这种数字,而不是整倍数)。
golangs := make([]int, 0)
for i := 0; i < 5; i++ {
    s = append(s, i)
    fmt.Println(len(s), cap(s)) // 1 1 / 2 2 / 3 4 / 4 4 / 5 8
}
实践建议
- 能预估长度的场景直接
make([]T, 0, n),避免多次扩容拷贝; - 扩容是值拷贝,元素是指针时只拷指针(浅拷贝);
append返回值必须重新赋值,因为可能产生新数组;- 共享底层数组的场景要小心:
b := a[:2]后append(b, x)若未扩容,会覆盖 a 的第三个元素。需要隔离时用slices.Clone或三索引切片a[:2:2]限制容量。
数组
数组各元素未赋值时,各元素默认为元素类型的零值。
数组指针为nil时,不能用来进行任何截取操作,但可以进行len()、cap()操作
特别注意
数组指针,即使为nil,也可以使用for range只迭代索引,使用len()、cap()仍然可以获取到数组的长度和容量,但这不是数组指针所指向的内容的长度,这是因为数组的长度是数组类型的一部分,而不是它值的一部分。对于固定大小的数组,其长度和容量在编译时就已经确定了。
如fmt.Println((*[3]int)(nil))打印出的值为nil,但是len((*[3]int)(nil))得到的长度为3。当使用for range (*[3]int)(nil)或者for k,_:=range (*[3]int)(nil)或for _,_=range (*[3]int)(nil)会循环三次,因为如果只迭代索引,Go的range机制不会解引用指针,而是直接计算长度(从类型信息获取),然后生成索引。但是不能使用for k,v:=range (*[3]int)(nil),也不能使用for _,v:=range (*[3]int)(nil),因为数组指针是nil,访问其所指向的数据会导致解引用空指针,所以在把数组元素赋值给v的时候,运行时会报空指针错误。
interface
interface包含了动态类型和动态值,判断是否等于另外一个interface,需要比较动态类型和动态值,先比较动态类型,如果动态类型不同,则直接返回结果。如果同态类型相同,则继续比较动态值。
如果动态类型相同,但却是不可比较类型,比如都是[]string这种类型,会发生panic(因为动态类型相同后,会比较动态值,但是动态值是不可比较类型的值)。
判断interface是否等于另外一个可比较类型(如Int、String)值,先比较interface的动态类型和后者类型,如果类型相同,然后再比较interface和后者的值
判断是否为nil时,需要动态类型和动态值都为nil,才相等。空interface与其他类型比较的时候(包括非interface类型),也是判断动态类型和动态值。
一个有方法的interface{},只能和 至少包含有这个接口的所有方法的interface{},空interface,nil 这三种比较。否则会编译不通过。
比如接口A只有方法hello()、Hi(),接口B也含有方法hello()、Hi(),另外B可能还含有其他方法,那么这两个接口是可以比较的
不可比较类型有map、slice、function、包含不可比较类型的结构体。
任何interface都可以类型断言为空interface,即x.(interface{})(如果x的动态类型实现了空interface{}类型对应的方法集合,就会成功,因为空interface{}本身已经是所有类型的实现了,所以除了动态类型为nil,必然成功),当动态类型为nil时,会断言失败(这么做一般没啥意义,实际开发中都是断言它的动态类型)。
interface 的底层结构
Go 的接口在运行时有两种结构:
golang// 空接口 interface{} / any
type eface struct {
    _type *_type         // 动态类型信息
    data  unsafe.Pointer // 动态值(值本身或指向值的指针)
}

// 非空接口(带方法的接口)
type iface struct {
    tab  *itab          // 类型 + 方法表
    data unsafe.Pointer // 动态值
}

type itab struct {
    inter  *interfacetype // 接口自己的类型信息(方法签名)
    _type  *_type         // 动态类型
    hash   uint32         // 类型哈希,用于类型断言快速过滤
    fun    [1]uintptr     // 变长数组:接口方法的实际函数地址
}
要点:
- 接口值 = 类型指针 + 数据指针,所以接口本身占 16 字节(64 位平台)。
itab里有方法表fun,接口调用方法时是一次间接跳转,比直接调用多一层寻址。Go 1.4 之后做了 itab 缓存,同一类型对同一接口只生成一次。- 值接收者实现接口时,
*T和T都能赋给接口(对*T会自动解引用);只有指针接收者实现接口时,只有*T能赋给接口(编译器不会自动对T取地址,因为值可能不可寻址)。 - 接口比较:先比动态类型,再比动态值。动态类型是切片/map/函数等不可比较类型时会 panic;两个 nil 接口相等,但「值为 nil 的接口」和「指向 nil 的具名指针装进接口」不相等(typed nil 陷阱):
golangvar p *int
var i interface{} = p
fmt.Println(i == nil) // false,因为 i 的动态类型是 *int
这也是 err != nil 却拿着一个 nil 具体值的经典坑——返回错误时应返回 nil 而不是 (*MyError)(nil)。
结构体
结构体嵌套:某属性包含另一个结构体
结构体继承:直接包含另一个结构体,自动创建一个默认的同名字段,并且会继承父结构体的方法,子结构体可以直接调用父结构体的方法,子结构体也可以通过定义一个同样的方法来重写继承而来的方法(遵循就近原则)。
不同的结构体之间不可直接比较,即使字段相同,顺序相同,也不能直接比较。(直接比较会编译不通过)
结构体方法,可以通过结构体实例、结构体指针来调用(编译器会自动解引用,需注意空指针问题)
结构体指针方法,也可以通过结构体指针、结构体实例来调用(编译器会自动取地址,需注意是否可取地址)
结构体和结构体指针可以互相调用彼此的方法,这种灵活性是 Go 语言的设计特性,编译器会自动处理解引用和取地址。但是需要自己注意空指针问题、是否可取地址等。
多级指针不会进行自动解引用(如不支持**T自动解引用到*T),仅支持单级指针(*T)自动解引用到结构体。同样也不支持对结构体多层自动取地址(如不支持T自动取地址到&&T),仅支持对结构体单层取地址。(为了保持代码的清晰和安全性)
在接口赋值时,如果只有结构体方法实现了接口所有方法,结构体实例和结构体指针都可以赋值给接口(编译器会自动对结构体指针进行解引用)。但是如果只有结构体指针方法实现了接口所有方法,则只有结构体指针可以赋值给接口(编译器不会自动取地址)。
不允许在同一个类型上同时定义值接收者和指针接收者的同名方法(无论方法参数是否相同),否则编译不通过,这是GO的语言规范明确禁止。
如果值方法和指针方法加起来才满足实现接口,则可以把指针赋值给这个接口,而不可把值赋值给这个接口。
不能对不可寻址的结构体直接修改其属性,如Student{}.age=18无法通过编译。但是可以显式地创建一个指向结构体值的指针,如(&Student{}).age=18可以正常编译。(本质就是,结构体属性赋值,必须要能取地址,然后通过地址找到其属性的存储位置,然后赋值)
特别注意
在匿名值或字面量上调用指针接收者方法或者给结构体属性赋值时,编译器不会进行自动取址,因为会造成语义不明确或其他错误。比如结构体字面量,又比如函数返回值。
如Student{}.setAge()和getStudent().setAge(),会因为Student{}字面量和getStudent()返回的结构体无法自动取地址,而都不能直接调用指针方法setAge()。
可以创建一个变量接收值,然后用这个变量去调用方法。或者显式地创建一个指向结构体值的指针去调用方法(&Student{}).setAge()
iota
iota是常量计数器,只能在常量表达式中使用
iota在const关键字出现时,将重置为0,const中每新增一行常量声明将使iota计数一次。
如果在同一个const里面遇到新的iota,则恢复为常量计数器。不复制上一个值,也不是在上一个值的基础上加。
字符串
Go里面的字符串,是只读的,本质是一个只读的字节切片(由指针和长度组成),指向一段不可变的内存区域。有len()方法,可以进行s[0:3]截取,但是没有cap()方法,截取时也不能指定容量位置。
定义了一个字符串,不能直接通过下标去修改,否则会编译不通过。
任何修改操作(如拼接、替换)都会创建新的字符串,而非修改原字符串。
多个字符串可共享同一段底层数据(如子串操作 s[:3]不复制数据)
若需要修改字符串内容,可以转换为[]byte或 []rune后进行修改(每次转换都触发内存分配)
strings.Trim、strings.TrimLeft、strings.TrimRight都是从字符串,连续删除第二个参数中含有的任意字符。
相关信息
如strings.TrimRight(str, cutset) 是从字符串str的右边(也就是结尾处)开始,连续删除cutset中含有的任意字符(注意是字符,而不是字符串),直到遇不到cutset中的字符为止。
strings.TrimRight("ABBA", "BA")结果为空字符串,需要注意和strings.TrimSuffix的区别,strings.TrimSuffix是删除完整后缀。
拼接大量字符串可以使用strings.Builder或bytes.Buffer预分配缓冲区,避免多次内存分配。
bytes.Buffer还可以支持拼接字符和字符串。
map
Go里面map的值是通过键来访问的,不可以直接获取map中单个元素的地址,因为map中的值是不可寻址的,也就是说它们不能直接被取地址(不能对map的属性进行取地址,map底层是一个哈希表,当map重新哈希时,元素的存储位置可能会发生变化)。
相关信息
与map不同,切片的元素是可以寻址的。因为切片的底层是一个数组,元素的位置比较固定,除非切片重新分配内存,比如切片发生扩容(Go会分配一个新的且更大的内存空间,不支持在原地址进行扩展)、直接修改切片的底层数组,会导致元素的地址发生变化。
可以直接对map取地址,但是不能直接用map的指针来操作其属性,也就是说不能直接对map指针进行索引(p[k] 编译不通过,但 (*p)[k] 是合法的)。
如果需要通过地址来访问map中的值,可以考虑使用类似这种格式map[int]*int,在map的value中保存真实的值地址,来达到类似的效果。
map没有cap方法,cap函数适用于数组、数组指针、slice、channel。
使用make初始化时,最多可以指定两个参数。第二个参数是容量提示(hint),虽然不能像切片那样精确控制容量,但Go会据此预先分配足够的桶,避免后续扩容,所以 make(map[int]int, 1000) 对性能是有实际意义的(注意它只是“提示”,最终桶数会向上取整到 2 的幂)。
map为nil也可以进行len()操作,也可以进行取值操作,但是取出的该类型的零值
Go语言中的map在并发读写时是线程不安全的,但并发读是可以安全的,前提是没有写操作在进行。
向 nil map 写入会 panic(
assignment to entry in nil map),必须先 make 或用字面量初始化。
map 的底层结构
Go 1.23 及以前,map 是哈希桶 + 拉链法的实现,核心结构是 runtime.hmap 和 runtime.bmap:
golangtype hmap struct {
    count     int            // 当前元素个数,即 len(m)
    flags     uint8          // 状态位:正在写、正在扩容、正在遍历等
    B         uint8          // 桶数量的对数:桶数 = 2^B
    noverflow uint16         // 溢出桶的大致数量
    hash0     uint32         // 哈希种子,每个 map 随机生成
    buckets    unsafe.Pointer // 指向桶数组(2^B 个 bmap)
    oldbuckets unsafe.Pointer // 扩容时指向旧桶数组,未扩容时为 nil
    nevacuate  uintptr        // 渐进式迁移的进度:已迁移到第几个旧桶
    extra      *mapextra      // 溢出桶的额外信息
}
golang// bmap 在源码里只是一个占位类型,真实布局由编译器在编译期展开
type bmap struct {
    tophash [8]uint8   // 8 个 key 的哈希高 8 位,用于快速过滤
    // 之后依次是:8 个 key、8 个 value、1 个 overflow 指针
}
几个必须记住的细节:
- 一个桶最多放 8 个键值对(
bucketCnt = 8)。超过 8 个就挂一个溢出桶(溢出桶通过指针串成链表)。 - key 和 value 是分开连续存储的,而不是
key1,value1,key2,value2这样交替存放。这样可以消除不同类型交替排列带来的内存对齐空洞,节省内存。 - tophash 存哈希值的高 8 位。查找时先比 tophash,只有 tophash 相同才去比较完整的 key,减少昂贵的 key 比较次数。
- 查找、插入、删除都需要先加锁吗?不需要——map 本身不加锁,
flags只用来检测并发写,检测到就直接throw(致命错误)。
哈希值如何定位到桶
- 用
hash0作为种子计算 key 的哈希(不同进程、不同 map 的种子不同); - 取哈希值的低 B 位决定落在哪个桶(
bucket = hash & (2^B - 1)); - 取哈希值的高 8 位作为 tophash,在桶内先比 tophash 再比 key。
为什么遍历 map 的顺序是随机的
两个原因叠加:① 每个 map 的 hash0 是随机的,同一批 key 在不同 map 里的落桶位置不同;② range 遍历时会随机选一个起始桶和一个起始 cell,然后按环形顺序遍历。
所以「遍历顺序随机」是刻意设计,目的是防止业务代码依赖遍历顺序。反过来说:任何时候都不要假设 map 有序,需要顺序就把 key 取出来排序(sort.Strings / slices.Sort)。
扩容机制(高频考点)
map 有两种扩容,触发条件不同、目的也不同:
| 类型 | 触发条件 | 结果 |
|---|---|---|
| 增量扩容(翻倍) | count > 8 * 2^B(即平均每个桶超过 6.5 个元素,装载因子 > 6.5) | B+1,桶数翻倍,减少哈希冲突 |
| 等量扩容(整理) | 溢出桶过多(B < 15 时 noverflow >= 2^B,B >= 15 时 noverflow >= 2^15) | B 不变,桶数不变,把元素重新紧凑排列,回收溢出桶 |
为什么会有「等量扩容」?因为大量删除后,桶里的元素很稀疏但溢出桶还挂着,查找要顺着链表走很长,性能退化。这时不需要更多桶,只需要把元素重新排列整齐。
扩容是渐进的,不是一次性搬完的:
- 触发扩容时,先分配新的桶数组,把
oldbuckets指向旧数组,nevacuate置 0; - 之后每次写操作(插入/删除)都会顺带迁移 1~2 个旧桶(
evacuate); - 读取时:如果该桶还没迁移,就去
oldbuckets读;如果已迁移,就去新桶读; - 迁移完成(
nevacuate == 2^B)后释放旧桶,oldbuckets置 nil。
特别注意
这正是 map 元素不可寻址的根本原因:扩容搬迁会让元素的地址发生变化。如果允许 &m[k],那么扩容后这个指针就指向了错误的位置(野指针)。所以 Go 在语言层面直接禁止对 map 元素取地址。
同理,map[key].Field = x 也无法编译(结构体字段赋值必须可寻址),只能整体赋值 m[k] = NewStruct(...) 或把 value 改成指针 map[K]*V。
Go 1.24 的变化
从 Go 1.24 开始,map 的底层实现换成了 Swiss Table(开放寻址 + 分组控制字节),不再使用 bucket + 溢出链,冲突多时不再有长链表,内存占用和查找性能都有改善。但上面这些结论依然成立:元素不可寻址、遍历无序、并发写会 fatal、删除不缩容。面试时如果被追问版本,可以提这一句。
并发安全
golangm := make(map[int]int)
go func() { for { m[1] = 1 } }()
go func() { for { m[2] = 2 } }()
// fatal error: concurrent map writes
- 并发读是安全的,并发写、读写混合都不安全;
- 报的是
fatal error: concurrent map read and map write/concurrent map writes,这是运行时直接throw,defer + recover 也兜不住,整个进程会退出; - 检测手段:编译时加
-race,数据竞争会在第一次冲突时被报告(比等 fatal 更早发现)。
四种解决方案对比:
| 方案 | 适用场景 | 说明 |
|---|---|---|
sync.Mutex + map | 读写都频繁、逻辑复杂 | 最简单,锁粒度大,但可控 |
sync.RWMutex + map | 读远多于写 | 读并行,写互斥;注意写饥饿问题 |
sync.Map | 读多写少、key 基本不变(缓存、注册表) | 读路径无锁,写多时会退化 |
| 分片锁(sharded map) | 高并发读写、key 分布均匀 | 按 hash 分 N 个 map,各配一把锁,降低锁竞争 |
sync.Map 的底层:内部是 read(atomic 读,无锁)和 dirty 两层。读命中 read 时完全不加锁;未命中会加锁去 dirty 找,同时累加 misses,miss 次数超过 dirty 长度就把 dirty 提升为 read。所以:
- 适合读远多于写、key 集合稳定的场景;
- 写多、key 频繁增删时,
dirty反复提升,性能反而不如Mutex + map; sync.Map没有len()(1.21 前后都不提供,需要Range计数),也不适合做需要遍历聚合的场景。
常见坑与优化
- key 必须是可比较类型:
slice、map、func不能做 key;包含这些字段的 struct 也不能做 key。接口类型做 key 时,动态类型必须可比较,否则运行时 panic。 - 删除不会缩容:
delete只把 tophash 标记为emptyOne,桶数组不释放。如果曾经有过百万级元素、后来删到只剩几个,内存仍然占着。解决办法:clear(m)(Go 1.21 引入,会重置 map、把 B 归零并释放桶)或重建一个新 map 把需要的数据拷过去。 - 遍历时删除是安全的:
for k := range m { delete(m, k) }是合法用法(规范允许);遍历时新增元素则行为不确定(可能遍历到、也可能遍历不到)。 - 预分配:能预估大小时用
make(map[K]V, n),避免多次扩容搬迁。 - value 是大结构体时用指针:
map[string]*BigStruct比map[string]BigStruct省一次拷贝,但会多一次内存分配和指针跳转,需要权衡。 - map 是引用语义:作为函数参数传递时传的是
*hmap,函数内增删改对外可见(但给形参重新赋值m = make(...)不影响外部)。 - 内存常驻:即使 map 是空的,
make后的桶数组也会占用内存,大量小 map 的场景要考虑对象池或合并存储。
如果map属性值为结构体
当使用 . 操作符来访问或修改结构体值的字段时,Go编译器会自动进行指针解引用。(编译期)
因此当map的属性值为结构体时,无法通过map[key].A的形式来修改,因为会解引用失败,编译会失败。
而当map的属性值为结构体的指针时,可以通过map[key].A的形式来修改,因为这个过程不会进行解引用,而是直接使用指针修改结构体的属性值。
但是可以通过map[key].A的形式来读取,因为Go程序运行时,会对不可寻址的结构体进行值拷贝,然后对拷贝的值进行指针解引用。
函数
函数只能与nil进行比较。函数、map、切片、channel都只能与nil比较
当函数使用命名返回值变量时,要注意不能在隐式return时(也就是return后面不接变量名)被同名的局部变量遮蔽,否则会编译失败。解决的方式是在同名局部变量的作用域之外进行return,或者在同名局部变量的作用域内进行显式的return(也就是return后面接同名的变量名)
闭包:在定义一个函数时,函数捕获外层函数的局部变量,并且这些变量的生命周期被延长(从栈逃逸到堆,生命周期与闭包函数共存)
方法
值方法,可以通过指针来调用;指针方法,也可以通过值调用;这是因为编译器会自动进行转换
指针调用值方法时,自动解引用;值调用指针方法时,自动取地址。
空指针可以调用指针方法。
特别注意
空指针调用值方法,编译能通过,但运行的时候会因为解引用nil,从而导致panic。
使用字面量调用方法时,由于字面量不能进行取地址操作,所以编译器无法将值类型转换成指针类型。如A为自定义类型,PointMethod()为*A的方法,那么A(2).PointMethod(),将无法通过编译。
多级指针编译器不会自动转换。如A为自定义类型,ValueMethod()为A的方法,PointMethod()为*A的方法,那么**A类型无法直接调用ValueMethod(),并且也无法直接调用PointMethod()。
方法值
将方法赋值给一个变量时(或者作为函数参数传递时),实际上是将方法本身与它的接收者(值或指针)的副本绑定在一起,相当于拷贝了一份接收者的值,可以理解为快照,当方法被调用时,会使用这个副本值作为方法接收者,不会随原始变量改变。
如果方法的接收者需要解引用操作(比如使用指针调用值方法),那么在方法赋值给变量的时候,就会立即完成解引用。然后拷贝一份解引用后的值作为接收者值。
channel
不能关闭一个只能接受数据的单向channel,编译不通过。但是可以关闭一个只能发送数据的单向channel。(close()就是用来关闭发送的)
向一个nil的channel发生数据会导致goroutine阻塞,从一个nil的channel接收数据也会导致goroutine阻塞。
给一个已关闭的channel发送数据会导致panic,从一个已关闭的channel接收数据,会先收到缓冲区数据,然后收到零值。
双向通道可以转为单向通道,但是单向通道不能转为双向通道。比如a:=make(chan int),可以通过chan<- int(a)来转换。
<-符号前后可以留空格,也可以不留空格,都可以通过编译。
channel的底层实现
channel的底层是runtime包里面一个hchan结构体,这个结构体里面包含了互斥锁、缓存容量、当前元素数量、环形队列指针、环形队列的发送索引、环形队列的接收索引、待发送数据的goroutine队列、待接收数据的goroutine队列、是否已关闭等等。
golangtype hchan struct {
    qcount   uint             // 当前队列中的元素数量(缓冲区已存在的数据量)
    dataqsiz uint             // 环形队列的大小(缓冲区大小)
    buf      unsafe.Pointer   // 指向缓冲区的指针
    elemsize uint16           // 单个元素的大小
    closed   uint32           // channel 是否已经关闭
    sendx    uint             // 环形队列中的发送索引(向channel发送数据时,元素存放的缓冲区位置索引)
    recvx    uint             // 环形队列中的接收索引(从channel接收数据时,读取的缓冲区位置索引)
    recvq    waitq            // 等待接收数据的goroutine队列
    sendq    waitq            // 等待发生数据的goroutine队列
    lock     mutex            // 保护channel数据结构的互斥锁
    ...
}
flowchart LR
id1["goroutine A"] --发送数据--> ide1
subgraph ide1 [channel内部]
direction TB
id(channel)-->加锁
加锁 --是否已关闭--> C{closed}
C--已关闭-->unlock["解锁"]-->panic(panic)
C--未关闭-->D{是否有待接收数据的goroutine队列}
D--有等待接收的goroutine-->将数据交给最早挂起的接收者-->解锁-->id2("唤醒该goroutine")
D--无等待接收的goroutine-->E{是否有可用的缓冲区}
E--有可用的缓冲区-->id3["将数据放入缓冲区sendx位置"]
id3-->id6(调整sendx和qcount的值)-->unlock2["解锁"]
E--无可用的缓冲区-->id5("发送者goroutine A加入待发送数据的goroutine队列")-->unlock3["解锁"]-->id4["发送者goroutine A被阻塞"]
end
channel 发送、接收的完整情形
理解 channel 的行为,关键是记住「缓冲区是否已满/已空」和「是否有等待的对方」这两个维度:
| 操作 | 无缓冲 | 有缓冲(未满/未空) | 有缓冲(已满/已空) |
|---|---|---|---|
发送 ch <- v | 阻塞,直到有接收者(直接交接) | 放入缓冲区,立即返回 | 阻塞,直到有空位 |
接收 <-ch | 阻塞,直到有发送者 | 从缓冲区取出,立即返回 | 阻塞,直到有数据 |
| 接收(已关闭) | 立即返回零值,ok=false | 先取完缓冲区数据,再返回零值 | 同左 |
| 发送(已关闭) | panic | panic | panic |
| nil channel | 永久阻塞 | 永久阻塞 | 永久阻塞 |
- 无缓冲 channel 是同步交接:发送方把数据直接交给接收方(
sudog直接传递,不走缓冲区),两者必须同时就绪。 - 有缓冲 channel 是异步队列:缓冲区是环形队列(
buf+sendx+recvx),发送/接收各自移动索引。 close只能由发送方调用,重复 close 会 panic;关闭后缓冲区里剩余的数据仍可被读完。len(ch)返回缓冲区中当前元素个数,cap(ch)返回缓冲区容量。注意len是瞬时快照,并发场景下没有参考意义。
常见使用模式
golang// 1. 用 channel 做信号量,限制并发数
sem := make(chan struct{}, 10)
for _, job := range jobs {
    sem <- struct{}{}
    go func(j Job) { defer func() { <-sem }(); handle(j) }(job)
}

// 2. 用 channel 实现超时
select {
case res := <-ch:
    return res
case <-time.After(3 * time.Second):
    return errors.New("timeout")
}

// 3. 用 close(ch) 广播退出信号(所有接收者同时被唤醒)
done := make(chan struct{})
go func() { for { select { case <-done: return; default: work() } } }()
close(done)

// 4. 用 channel 做一次性锁(容量为 1 的信号量)
lock := make(chan struct{}, 1)
lock <- struct{}{}
<-lock
特别注意
time.After不要放在 for 循环里:每次都会新建一个 Timer,在超时前不会被回收,高频循环会造成大量定时器和内存堆积。改用time.NewTimer+Reset。- 向已关闭的 channel 发送会 panic,多发送者场景下关闭 channel 要格外小心,通常由「唯一的发送方」或「协调者」负责关闭。
- channel 不是队列的通用替代品:需要堆积、背压、重试、持久化时,用真正的队列(或带缓冲的 worker pool),别把业务逻辑塞进 channel。
语法
defer
defer执行时机,return第一阶段(赋值,把将要返回的值赋值给变量进行存储,这个变量可能是具名变量或匿名变量)、执行defer进行收尾、return第二阶段(携带最终值退出)
defer在注册的时候(也就是入栈的时候),就已经确定了传入的参数值,也确定了函数体。如果参数值是函数调用,则在注册的时候,就会从左到右,立即依次计算出真正的参数值。如果是链式调用,defer注册时,就会先计算前面所有的函数,并把结果作为方法参数,只有最后一个函数会延迟执行。(闭包除外,闭包会等defer真正执行时,才会确定变量的值)
当函数内部发生panic时,该函数中所有的defer语句都仍然会被执行,当defer中发生panic时,会中止当前 defer 的执行,但会继续执行后续的 defer。
recover
recover的作用是捕获异常,recover()会使程序从panic中恢复,返回panic信息。
recover必须与defer一起使用,并且必须直接包含在defer注册函数的函数体中(在这个注册函数体中调用recover()时,可以defer cover()),可以是匿名函数中。不能进行多次封装或者嵌套。
注
recover()必须在panic的调用链上的某个defer函数中直接调用。也就是说recover()能捕获当前goroutine中所有尚未处理的panic,只要在同一个函数调用链,并且该panic发生在recover()所在的defer函数执行之前。
for range
- for range 在循环之前,就已经确定了循环的次数。
- for range 前面的临时变量,只会创建一次,然后每次重新赋值,即始终为同一个变量。
- 仅仅遍历切片,忽略具体业务时,普通的for语句的性能稍微更好一点,但是可以忽略,相差很小。主要是for range需要同时管理索引和值的获取。
- for range开始迭代时就浅拷贝了一个副本,对数组来说,相当于拷贝了一个新的数组进行迭代,修改原数组不会影响被迭代数组。而对于切片来说,range拷贝出来的切片与原切片底层是同一个数组,因此对原切片的修改也会影响到被迭代切片。
- for range 遍历的切片、map为nil,或者遍历的数组指针为nil时,不会报错。
- for range 前面可以不写变量,如
for range []int{1,2}也可以,只是无法获取元素值。 - for range 与 for k,v:=range 与 for k,_:=range 在内部实现上是由差异的。具体例子可以查看数组小节的特别注意
特别注意
如果在迭代切片循环的过程中,改变了原切片地址,则对原切片的修改不会影响被迭代切片。
比如在迭代的过程中,使用append给原切片追加元素导致扩容后,原切片的地址会发生改变,这时如果修改了原切片的元素,则不会影响到被迭代切片。
- for range也可以遍历一个数组指针,实际上是将数组的指针传递给被迭代的变量。这样,在被迭代的是数组引用的拷贝。另外即使被迭代的是数组指针,迭代出来的元素仍然是数组元素的副本,而不是指针(类似于切片引用传递)
for range 遍历数组指针比遍历数组更高效(避免整个数组拷贝,而是仅拷贝数组指针)
select case
对于case后面的表达式或语句,除了每个case的最后一步<-或->操作以外,其他操作的是根据case的顺序从上到下的执行,直到每个case都只剩下最后的<-或->操作。
注
例如下面会先执行A(),然后执行B(),等A()和B()都完成后,才会从case和deault中根据条件选一个执行里面的代码块。
select {
    case a<-A():
        ...
    case b<-B():
        ...
    default:
        ...
}
对于包含通道通信操作的 select 语句,如果有多个 case 准备好的话(只剩下最后的<-或->操作,并且具备完成<-或->操作的条件),会进行随机选择。
所有的case都不满足时(都只剩下最后的<-或->操作,并且都不具备完成<-或->操作的条件),才会走default
for 与 select 的组合中,break只会跳出select块,然后从select块结束的地方继续执行,不会跳出for循环
for 与 select 的组合中,continue会从当前位置开始for的下一次循环,与直接在for循环中使用continue没有区别
switch case
switch后面没有条件时,默认为true。(如switch {等于switch true {)
switch后面的条件必须要和
{在同一行,否则由于golang会自动在switch行尾补充;进行断句。从而使是switch a()变为switch a();true {,switch条件由a()变为了true。
默认自带break,可以写fallthrough来贯穿case
所有的case都不满足时,才会走default
break label
单独的break表示退出当前循环
break label中label是放在循环之前的一个标识,可以明确的指出要退出哪个循环
init
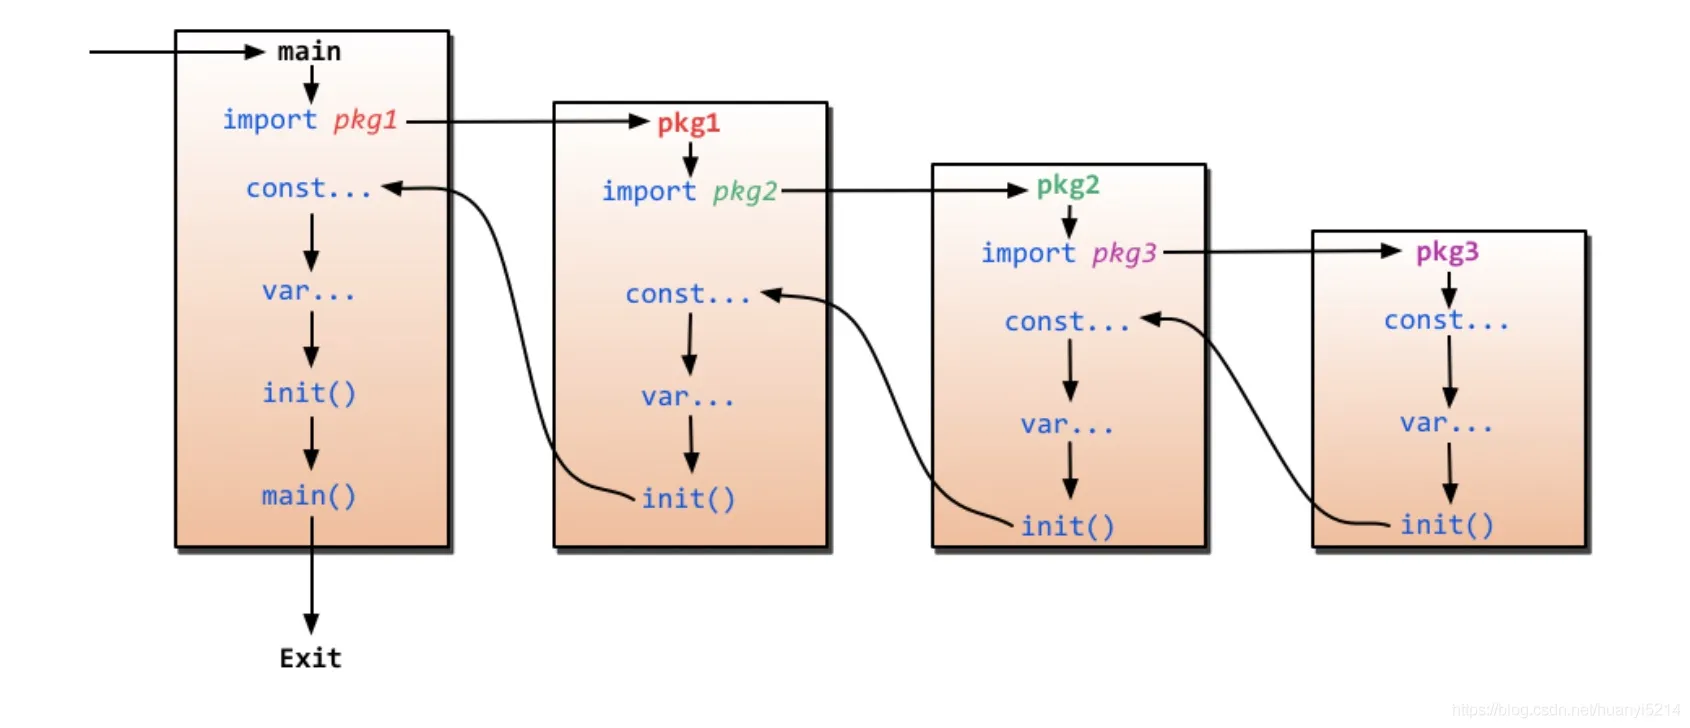
同一个go文件里面,init执行顺序是从上到下。同一个package里面不同的go文件里的init执行是按照编译时读取文件的顺序。不同的package里面的init执行,是根据包名的英文字母排序执行(import后面的所有字母以/分隔对比每一项),如果有嵌套的,需要等到嵌套的init先执行,嵌套里的init也要根据字母顺序排队。golang中包的初始化,是串行执行的。如果有嵌套则按照如下图的顺序执行。
init函数不能被其他函数调用,包括main函数。
goto
goto跳转的目标标签,需要跟goto在同一级别或者更外层代码块。也就是说只能直接跳入同级和或者更外层代码块,不能跳入内层的代码块,也不能跳转到其他函数。
操作符
操作符优先级
.(成员访问操作符) 大于 [](索引操作符) 大于 *(解引用操作符) 等于 &(取地址操作符) 大于 ++或--(自增或自减操作符)
如对结构体
t的某个属性取地址可以直接&t.n,等价于&(t.n)
&和*都是右结合的,比如**p会先计算右边的*p,相当于*(*p)。
运算符优先级:一元运算符在一般的运算符中有最高的优先级。一元运算符包含"+"、"-"、"!"、"^"、"*"、"&"、"<-"。比如:5/+-*v 相当于5/(0+(0-(*v)))
注
左结合与右结合的区别:
- 左结合,从左开始计算,大多数算数运算符是左结合
- 右结合,从右开始计算,赋值运算符(=)、一元运算符等等
运算符^有两种用途:
- 二元运算符,按位异或,对应二进制位不同则为1,相同则为0
- 一元运算符,按位取反,0变1,1变0
赋值
不能使用短变量声明:=来设置字段值,无论是结构体、数组、切片、map等,如user.Age := 12会编译失败。
对于使用:=定义的变量,如果新变量与同名,已定义的变量不在同一个作用域中,那么 Go 会新定义这个变量
对于多值赋值语句,类似于a,b=1,2+a或者a,b:=1,2+a,执行顺序是从左到右,但是左边的运算结果不会影响右边的运算结果,他们都是独立的操作,表达式里面引用的都是这条语句之前的变量值。如果等号前面的不是变量,而是索引表达式(如s[i]),也同样是引用的是这条语句之前的s(包括所有属性,如len、cap等)
i++ 和 i–- 在 Go 语⾔中是语句,不是表达式,只能做为独立语句,不能赋值给另外的变量,这点与其他语言不一样。
常量与变量
变量
函数中声明的变量必须要使用,但是可以有未使用的全局变量。函数参数未使用也是可以的。
小妙招
如果有暂时没有使用的变量可以这样 _ = a或者b = b,也是可以的
不使用显式类型,无法用nil来初始化变量,如a:=nil会编译失败,因为编译器无法确定类型
使用字面量定义数组、切片、结构体、map等多元素类型时,如果最后一个元素跟}不在同一行,结尾也需要加逗号。
匿名变量
匿名变量是指在程序运行过程中产生的、没有显示绑定到变量名的中间值(临时值),如函数返回值、表达式计算结果。
在Go中不能对匿名变量取地址,因为匿名变量通常是临时存储在栈上,生命周期很短,如果允许取地址,可能导致悬挂指针(即指针指向已被释放的内存),破坏Go的内存安全保证。
常量
- 在Go语言中,常量是一个简单的标识符,不会被修改,常量未使用时能编译通过。
- 在Go语言中,常量是在编译时期就固定的值,是硬编码在程序中的值,并没有内存地址,所以是不可寻址的,因此不能取其地址。如果你尝试取一个常量的地址,就会报错,编译不通过。
- 无类型常量可以根据需要自动适配到其他类型,字面量是也是无类型常量,如
const a=1就是无类型常量,可以根据需要自动适配int、uint、int64、int32等类型 - const关键字只能用于定义基本类型的常量(即常量只能是基本类型),包括
布尔值、数值(整数、浮点数和复数)、字符串,以及基础类型为这些类型的自定义类型,如type A int - 不赋值的常量会在编译时,被赋值为上一个常量的值或者占位符常量的值,如果前面没有常量或者没有类似
_ int = 123这样的占位符定义,会编译不通过。
字面量
直接写在代码中的固定值,既可以是基本类型(如int,string),也可以是复合类型(如slice,struct)
小字面量(如基本类型),若字面量未逃逸且无需地址化,可能直接被编译为指令数据。若绑定到局部变量且未逃逸,分配在栈上。若字面量的地址逃逸(如返回指针或被闭包捕获),分配到堆上。
大字面量(如大数组或结构体),即使未逃逸,也可能直接在堆上分配(因栈空间有限)。
引用类型字面量,引用类型的字面量(如 slice、map、chan 的复合字面量)底层数据必定在堆上
普通指针的字面量,逃逸则堆,未逃逸则栈。
字符串字面量(如 "hello"),通常是只读的全局数据,在编译期存入程序的静态区(非堆非栈)。
字符串字面量赋值给变量时(如s:="hello"),的string头部结构可能分配在栈或堆,但数据始终指向静态区。而动态生成的字符串(如拼接、转换)会按逃逸分析规则分配内存。
基础类型的字面量(如 42, 3.14, "hello")是不能直接取地址的,但对于复合字面量(结构体、数组、切片、map),Go允许直接取地址(如p := &[]int{1, 2, 3})。当对复合字面量取地址时,编译器会先在栈或堆上分配内存(由逃逸分析决定),然后返回该内存的地址。
要注意字面量和匿名变量的区别:不能对匿名变量取地址,无论什么类型。
类型别名与类型定义
类型别名带有本身类型的所有方法
但是类型定义不具有原类型的方法
值类型与引用类型
- 值类型内存通常直接在栈中分配,
- 引用类型内存通常在堆上分配,变量本身仍然是在栈上存储其指针或引用的
注
在 Go 语言中,每个变量的内存分配都由编译器完成。对于大部分的变量,特别是小的数值类型、bool 类型、指针和短小的结构体等,它们的值会被直接存储在栈上。当你通过变量名访问这些变量时,程序会直接从栈上读取对应的值。
在运行时,Go 编译器已经决定了每个变量的存储位置,包括栈上的位置。这样,当你通过变量名访问变量时,程序会根据编译时决定的存储位置,在栈上定位变量的值并进行读取操作。
需要注意的是,Go 语言的变量可能也会被编译器进行逃逸分析,部分变量可能会逃逸到堆上进行分配,这通常发生在变量的生命周期跨越了编译器能够确定的范围,例如返回指针、闭包等情况。在这种情况下,对于逃逸到堆上的变量,通过变量名找到值的过程也会不同,需要通过堆上的指针进行访问。
总的来说,对于大部分情况下的变量,通过变量名找到栈上存储的值,是一个简单而高效的过程,由编译器的指令来实现。而对于逃逸到堆上的变量,访问方式会有所不同,通常需要通过堆上的指针来间接访问。
在 Go 语言中,函数返回的指针所指向的值,以及闭包变量的值,可能会存储在堆空间或者栈空间,具体取决于编译器的逃逸分析和优化行为。
逃逸分析是编译器在编译期间的一项重要工作,用于决定变量的生命周期。对于那些在函数结束后不再被引用的变量,编译器可以优化地不分配栈空间,而是将其分配到堆上。这种情况下,函数返回的指针所指向的值以及闭包变量的值就会存储在堆空间中。
对于那些逃逸到堆空间的变量,它们的生命周期可能会比函数的生命周期更长,所以编译器会将它们分配到堆上,以便随时可以被访问。
需要注意的是,即使变量的值存储在堆上,变量本身的指针或引用可能仍然存储在栈上。这样的设计既充分利用了栈空间的高效性,又能够避免因为局部变量的生命周期而带来的额外开销。而对于较大的数据或者生命周期较长的变量,将其分配到堆上可以减少栈空间的使用,并优化内存的管理和利用。
因此,函数返回的指针所指向的值,以及闭包变量的值,可能存储在堆空间或栈空间,具体取决于编译器的逃逸分析决策。
关键字与预定义标识符
关键字
用于语法结构和流程控制,具有特点的语法功能和含义,不能用作变量名和函数名,Go语言中有25个关键字,如break、const、var、func、struct等等
预定义标识符
预先定义的标识符,包括基本类型、常量、nil、内建函数等,可以在代码中重新定义或作为变量名被赋值,Go语言中有37个预定义标识符,如int、string、bool、true、false、iota、nil、len、cap、append、make、new等等
同步
互斥锁
sync.Mutex是值类型。当互斥锁作为方法的接收者或者参数时,要注意避免值复制,否则会导致互斥锁不生效(因为是两个不同的锁)。Lock()与Unlock()方法的接收者为指针类型*sync.Mutex,所以当需要把sync.Mutex进行函数传参时,一般传入同一个sync.Mutex变量的指针,这样可以保证加锁和解锁作用于同一个sync.Mutex变量。
相关
不仅仅是sync.Mutex变量,sync.WaitGroup也不要进行值传递,因为它们会作用于不同的实例。
当 sync.Mutex 变量直接赋值给另一个变量时,它的当前状态(即 state 字段,类型为 int32,记录互斥锁的状态)也会被复制过去。而 sync.WaitGroup 由于是不可复制的类型,如果将一个 sync.WaitGroup 变量赋值给另一个变量,编译器会报错。
sync.WaitGroup在调用Wait()方法执行完成后,可再继续调用Add()方法和Wait(),但是不能在Wait()调用的同时,去调用Add(),否则会报运行时错误,这是为了防止数据竞争。
RWMutex(读写锁)
- 读锁共享(多个 goroutine 可同时
RLock),写锁独占; - 写优先:已经有写者在等待时,后来的读者会被阻塞,防止写操作被源源不断的读请求饿死;
- 不可重入:持有读锁时再去
Lock()会死锁(读写锁互相等待);持有写锁时再RLock()同样死锁; - 适用场景:读远多于写(缓存、配置表)。读操作本身很快时,
RWMutex的额外开销(原子计数、唤醒)可能比Mutex还大,不要盲目替换。
WaitGroup
- 内部是计数器 + 信号量(
sema)。Add(n)加计数,Done()减一,Wait()阻塞到计数归零; Add必须在Wait之前完成。如果在 goroutine 内部Add,可能出现Wait已经返回、Add才开始执行的竞态,导致漏等待;- 计数不能为负(
Done多于Add会 panic:sync: negative WaitGroup counter); Wait返回后可以复用同一个WaitGroup(Add再Wait),但不允许Wait与Add并发进行;- 同样不能值拷贝(
go vet会报copylocks)。
Once / Cond / Pool
sync.Once:保证函数只执行一次。实现是「原子读标记 → 未完成则加锁 → 双重检查 → 执行 → 置标记」。注意:如果Do里的函数 panic,Once仍然认为已执行完,后续调用不会重试。sync.Cond:条件变量,Wait()会释放锁并阻塞,被唤醒后重新加锁。Signal唤醒一个,Broadcast唤醒全部。使用前提是必须持有对应的锁,且用for循环检查条件(防虚假唤醒)。sync.Pool:临时对象复用池。每个 P 有一个私有槽位 + 一个共享队列,取对象时优先私有、再共享、最后其他 P(偷)。GC 会清空 Pool(对象在两个 GC 周期内未被使用就会被回收),所以它只能缓存「可重建的临时对象」(如bytes.Buffer、[]byte),不能当连接池或持久缓存用。
原子操作与内存序
golangvar counter atomic.Int64   // Go 1.19+ 的类型化原子值
counter.Add(1)
n := counter.Load()
sync/atomic提供Add/Load/Store/Swap/CompareAndSwap;atomic.Value可以存任意类型,但要求所有写入的类型一致,且不能存 nil;- 原子操作只能保护单个字段。多个字段之间存在不变式(比如「余额 + 流水必须一致」)时,原子操作不够,必须用锁;
- Go 的内存模型是 happens-before:
Mutex的Unlock先于后续的Lock、channel 的发送先于对应接收、Once.Do返回先于所有Do返回。没有这些同步关系保护的并发读写,就是 data race。
特别注意
- Go 的
map并发写是 fatal error,不能 recover;-race只能帮你发现问题,不能修复; go test -race、go run -race、go build -race都可用,线上不要带-race(性能损失 5~10 倍);- 死锁检测:运行时只能检测「所有 goroutine 都已阻塞」的全局死锁(
all goroutines are asleep - deadlock!),互相等待的局部死锁检测不到,需要靠pprof的 goroutine profile 分析。
并发编程
context
context 用于在调用链上传递「取消信号 / 超时 / 请求域数据」,是 Go 并发的标准基础设施。
golangctx, cancel := context.WithTimeout(context.Background(), 3*time.Second)
defer cancel() // 必须调用,否则定时器和子 context 会泄漏

select {
case <-ctx.Done():
    return ctx.Err() // context.DeadlineExceeded 或 context.Canceled
case res := <-doWork(ctx):
    return res
}
使用规范(也是面试常问):
- 作为函数的第一个参数,命名为
ctx,不要塞进结构体; - 不要传
nil,不确定就用context.TODO(); WithValue只放请求域元数据(trace id、用户身份),不要用它传业务参数;cancel必须调用(defer cancel()),即使已经超时,否则父 context 的子节点不会被释放;context本身是并发安全的,可以被多个 goroutine 同时使用;- 取消是协作式的:被调方必须主动检查
ctx.Done(),否则取消不会生效。
goroutine 泄漏
goroutine 泄漏是 Go 线上事故的高频原因,因为泄漏的 goroutine 会一直占着栈内存,且 GC 不会回收「还在阻塞的 goroutine」。
常见场景:
| 场景 | 原因 | 修复 |
|---|---|---|
| channel 阻塞 | 向无接收者的 channel 发送,或从无发送者的 channel 接收 | 用 select + ctx.Done(),或确保有消费方 |
| 忘记取消 context | 派生 context 后未 cancel,下游 goroutine 永久等待 | defer cancel() |
| 死循环 | for {} 没有退出条件 | 加退出信号 / ctx 检查 |
time.Ticker 未 Stop | 定时器一直存活,goroutine 一直被唤醒 | defer ticker.Stop() |
| HTTP 请求未关闭 Body | 连接不释放,读 goroutine 挂住 | defer resp.Body.Close() |
| 无限启动 | 每个请求都 go func() 且没有并发上限 | 用 worker pool / 信号量限流 |
排查手段:runtime.NumGoroutine() 打点监控、pprof/goroutine(看 goroutine profile 的堆栈聚合)、测试里用 go.uber.org/goleak。
常见并发模式
golang// worker pool:固定 N 个 worker 消费任务
jobs := make(chan Job, 100)
for i := 0; i < runtime.NumCPU(); i++ {
    go func() { for j := range jobs { handle(j) } }()
}

// fan-out / fan-in:分发到多个 goroutine,再汇总结果
// pipeline:多级 channel 串联,每级一个 goroutine
// errgroup:并发执行 + 第一个错误即取消
g, ctx := errgroup.WithContext(ctx)
for _, u := range urls {
    u := u
    g.Go(func() error { return fetch(ctx, u) })
}
if err := g.Wait(); err != nil { return err }
并发与并行的区别
- **并发(concurrency)**是「同时处理多件事」的结构,是代码组织方式;
- **并行(parallelism)**是「同一时刻真的在多核上执行」,是运行时行为;
- Go 的 goroutine 让「并发」 cheap(几 KB 栈、用户态切换),
GOMAXPROCS决定同时能在几个核上并行; - 并发度可以远大于并行度,调度器负责在有限的 M 上复用 G。
运行时
GC
垃圾回收器(GC)负责管理内存,它会识别和回收不再被引用的数据空间,无论它们是在堆上分配还是在栈上分配的。
Go 的 GC 是并发、三色标记、标记-清除、不压缩、不分代的回收器。这几个定语每一个都是面试考点。
三色标记法
把对象抽象成三种颜色:
- 白色:尚未被访问,标记结束后仍是白色 → 判定为垃圾;
- 灰色:已访问,但它引用的对象还没扫描完(在待处理队列里);
- 黑色:自己和所有子对象都扫描完了,确定存活。
流程:从 GC Roots(全局变量、goroutine 栈上的变量、寄存器)出发标灰 → 不断从灰色集合取对象,把它引用的对象标灰、自己变黑 → 灰色集合为空时,剩下的白色对象就是不可达垃圾。
并发标记的核心难点:标记期间业务代码还在改指针。如果不管,可能出现「黑色对象引用了白色对象,而这条路径上再没有灰色对象」,导致白色对象被误删。为此需要写屏障:
- 插入屏障(Dijkstra):新增引用时,把被引用的对象标灰;
- 删除屏障(Yuasa):删除引用时,把被删除的对象标灰;
- Go 1.8 起的混合写屏障:结合两者——被删除的引用标灰、新插入的引用标灰;同时在 GC 开始时把栈上所有对象一次性标黑(此时有一次极短的 STW),之后新分配的对象直接标黑。
混合写屏障的意义:标记过程中不需要再 STW 重扫 goroutine 栈。Go 1.7 及以前每次 GC 结束都要停下来重新扫描所有栈,STW 达到毫秒甚至几十毫秒。
GC 的四个阶段
| 阶段 | 是否 STW | 做什么 |
|---|---|---|
| Mark Setup | 是(极短) | 开启写屏障,准备标记队列 |
| Marking | 否(并发) | 三色标记;后台标记 goroutine 占约 25% CPU,业务 goroutine 通过「辅助标记」参与 |
| Mark Termination | 是(极短) | 关闭写屏障,统计存活对象,决定下次触发阈值 |
| Sweeping | 否(并发、惰性) | 按 span 清理白色对象,在后续分配时按需进行 |
Go 1.14 之后 STW 通常在几十微秒量级(目标是 < 100µs),所以「Go 的 GC 停顿很长」这个说法在 1.8 之后已经不成立。
辅助标记(mutator assist):如果业务分配速度太快,超过了后台标记的进度,分配内存的 goroutine 会被「罚款」——必须帮忙标记一段时间才能继续分配。这是为了防止堆无限膨胀。
触发条件
GOGC(默认 100):堆内存增长到「上次 GC 后存活堆大小」的 2 倍时触发。设GOGC=200就是 3 倍,GOGC=off关闭;GOMEMLIMIT(Go 1.19+):软内存上限,接近上限时更积极地 GC,用于容器环境防止 OOM;- 强制触发:距上次 GC 超过 2 分钟(
forcegcperiod)会强制来一次; - 手动:
runtime.GC()(会阻塞到本次 GC 完成,生产代码慎用)。
不压缩、不分代带来的影响
- 不压缩(non-moving):对象地址固定,所以可以把栈地址、C 指针安全地传出去;代价是存在内存碎片,靠 67 种 size class 减少碎片,但无法彻底整理;
- 不分代:没有新生代/老年代之分,每次 GC 都扫描全堆(标记阶段),短命对象多的场景效率不如 Java 的分代收集器。Go 靠逃逸分析把大量对象留在栈上(栈随函数返回直接释放,不参与 GC)来缓解这个问题;
- 因此 Go 的优化方向是「少分配」而不是「调 GC 参数」:预分配、对象池、避免不必要的接口装箱和字符串拼接。
内存分配器(三级结构)
Go 的内存分配器借鉴了 TCMalloc:
| 层级 | 作用 | 特点 |
|---|---|---|
mcache | 每个 P 私有缓存 | 分配无锁,最快路径 |
mcentral | 全局,每种 size class 一个 | 多个 mcache 共享,需要加锁 |
mheap | 堆,向操作系统申请内存 | 以 8KB 页为单位管理,大对象直接从这里分配 |
- 内存按 67 种 size class(8B ~ 32KB)切分,
mspan是「若干连续页」的管理单位; - 小于 16 字节且不含指针的对象走 tiny allocator,多个小对象合并到一个 block,减少浪费;
- 大于 32KB 的大对象绕过 mcache/mcentral,直接从 mheap 分配;
- 分配路径:
mcache→ 缺失则向mcentral要 → 再缺则向mheap要 → 再缺则向 OS 申请。
逃逸分析
编译器在编译期决定变量分配在栈还是堆:能确定生命周期不超出函数作用域就放栈(函数返回即释放,不产生 GC 压力),否则「逃逸」到堆。
常见逃逸场景:
- 函数返回局部变量的指针;
- 闭包捕获并引用了外部变量;
- 变量被赋给
interface{}(装箱,如fmt.Println(x)、errors.New外的包装); - 变量太大(超过栈对象大小限制)或大小在编译期不确定(如
make([]int, n)); - 指针被发送到 channel、存入全局变量、被其他 goroutine 引用;
- 切片/ map 扩容导致底层数组重新分配,旧数组被外部引用。
查看方式:
bashgo build -gcflags="-m -l" ./...     # -m 输出逃逸决策,-l 禁止内联(避免内联干扰判断)
go build -gcflags="-m -m" ./...     # 更详细的原因
为什么这件事值得关注
堆分配需要:分配器找空间 → 可能触发 GC → 对象存活期间一直被扫描。栈分配只需要移动栈指针,函数返回自动回收。同样是创建一个对象,栈上分配的成本可能只有堆分配的几十分之一。所以「减少逃逸」是 Go 性能优化里性价比最高的一类手段。
调度
goroutine进入“就绪”状态后才会被放入调度队列,等待调度器为其分配CPU时间片后进行执行。
为什么 Go 需要自己的调度器
内核线程(OS Thread)的代价太高:默认栈 1~8MB、创建/销毁涉及系统调用、上下文切换要陷入内核(微秒级)。如果每个 goroutine 都对应一个线程,万级并发就崩了。
Go 采用 M
调度:把 M 个 goroutine 复用到 N 个内核线程上,调度发生在用户态(纳秒~百纳秒级),并且 goroutine 的栈从 2KB 起按需增长。这是「Go 能轻松开几十万 goroutine」的根本原因。G、M、P 三者的职责
| 角色 | 全称 | 职责 |
|---|---|---|
| G | goroutine | 用户态协程。保存栈、程序计数器、状态、绑定的 M 等信息 |
| M | machine | 内核线程,真正执行代码的实体。通过 mstart 进入调度循环,持有 mcache |
| P | processor | 逻辑处理器,调度上下文。持有本地运行队列(256 个)、mcache、timer 等。数量由 GOMAXPROCS 决定,默认等于 CPU 核数 |
关键理解:M 必须绑定 P 才能执行 G。P 是「执行许可证」——它既限制了并行度(同时只有 GOMAXPROCS 个 G 在真正跑),又保存了调度所需的本地状态(队列、缓存),避免每次调度都去全局结构上抢锁。
flowchart LR
subgraph P1[P0]
  R1["本地队列 runq (256)<br/>runnext"]
end
subgraph P2[P1]
  R2["本地队列 runq (256)"]
end
GQ["全局队列 sched.runq"]
M1["M0 (内核线程)"] --> P1
M2["M1 (内核线程)"] --> P2
P1 --> G1["G"]
P2 --> G2["G"]
R1 -.满时转移一半.-> GQ
GQ -.取一批.-> R1
R1 <-.work stealing 偷一半.-> R2
G 的状态机
_Gidle → _Grunnable → _Grunning → _Gsyscall / _Gwaiting → _Gdead
_Grunnable:在运行队列里排队,等待被 M 执行;_Grunning:正在 M 上执行;_Gwaiting:阻塞等待(channel、mutex、网络 IO),不占 P,被唤醒后回到_Grunnable;_Gsyscall:正在执行系统调用,此时 M 与 P 解绑;_Gdead:执行结束,结构体被放回池中复用。
调度时机(什么时候会切换)
- 执行
go语句创建新 goroutine,可能触发队列调整; - 当前 G 主动让出:
runtime.Gosched(); - 当前 G 阻塞:channel 收发阻塞、
Mutex.Lock阻塞、time.Sleep、网络 IO; - 系统调用阻塞(M 被占用,P 需要 hand off);
- 时间片用完 / 被抢占(sysmon 触发,运行超过 10ms);
- GC 需要 STW 或辅助标记;
- 函数调用时栈空间不足(需要栈增长)。
队列与 work stealing
每个 P 有一个本地运行队列(最多 256 个 G),还有一个 runnext 槽位存「下一个要跑的 G」,用于提高缓存局部性(刚创建的 G 与创建者大概率数据相关,优先在同 P 执行)。
当 M 上的 G 执行完,调度器按以下顺序找活干:
- 本地队列:取
runnext,没有就取队头; - 全局队列:本地空了,从
sched.runq取一批(一次取len/2 + 1个,避免锁竞争); - netpoll:检查网络 IO 是否有就绪的 G;
- work stealing:随机挑另一个 P,偷它一半的 G(最多尝试 4 次)。
work stealing 的作用是负载均衡:某个 P 特别忙时,空闲的 P 会把活偷走,避免「一个核累死、其他核闲着」。
hand off(P 的移交)
当 G 进入系统调用(_Gsyscall):
- M 会释放 P(
entersyscall),P 变成空闲状态,可以被其他 M 拿走; - 如果系统调用很快返回,M 尝试重新拿到原来的 P;拿不到就把 G 放到全局队列,自己进入休眠;
- sysmon 会检测长时间阻塞在系统调用里的 P(超过 10ms 会强制收回,
retake),保证并行度不被一个慢系统调用拖死。
抢占式调度
- Go 1.14 之前是协作式抢占:编译器在函数序言里插入栈检查指令,G 调用函数时才检查「是否需要让出」。所以
for {}这种没有函数调用的死循环永远无法被抢占,会把 P 卡死(如果GOMAXPROCS=1,整个程序卡住)。 - Go 1.14 起是异步抢占:sysmon 发现某个 G 运行超过 10ms,就向对应的 M 发送
SIGURG信号,信号处理函数里把 G 挂起、重新调度。这样任意指令边界都能被抢占,死循环也能被中断。 - 抢占是「基于信号的协作」,需要 cgo 和汇编部分配合,用
runtime.asyncPreempt保存现场。
sysmon(系统监控线程)
一个不绑定 P、不需要调度的独立 M,启动后一直在后台循环,是运行时的「巡逻队」:
| 职责 | 说明 |
|---|---|
| 抢占长时间运行的 G | 超过 10ms 就发信号抢占 |
| 收回被系统调用占用的 P | 超过 10ms(forcePreemptNS)强制 retake |
| 触发强制 GC | 超过 2 分钟没有 GC 就触发一次 |
| 处理 netpoll | 把网络就绪的 G 放回运行队列 |
| 内存回收(scavenge) | 把空闲内存还给操作系统 |
sysmon 的轮询间隔是动态的:刚开始 20µs,空闲时指数退避到 10ms,有活干时再加快。
goroutine 的栈
- 初始栈只有 2KB(Go 1.4 之前是 4KB/8KB,之后改成连续栈);
- 栈不够时触发
morestack:分配一个两倍大的新栈,把旧栈内容拷过去,并修正所有指向旧栈的指针,然后继续执行; - 最大栈 1GB(64 位)/ 250MB(32 位);
- 因为栈会移动,所以不能把 Go 栈上的地址长期传给 C 代码(cgo 的指针传递规则也源于此),也不能依赖栈地址不变。
GOMAXPROCS
- 决定同时有多少个 G 能在 CPU 上并行执行,默认等于逻辑 CPU 数;
- 它不限制 goroutine 的总数(可以创建百万个),只限制并行度;
GOMAXPROCS=1时仍然是并发(交替执行),但没有并行;- 容器环境注意:Go 1.25 之前默认读的是宿主机核数,可能出现「限制 2 核却开了 64 个 P」导致频繁切换,需要手动
GOMAXPROCS或引入automaxprocs;Go 1.25 起运行时默认会考虑 cgroup 的 CPU 限制。
goroutine 与线程的对比
| 维度 | goroutine | 内核线程 |
|---|---|---|
| 初始栈 | 2KB,按需增长 | 1~8MB,固定 |
| 切换成本 | 用户态,约百纳秒 | 内核态,约微秒 |
| 调度者 | Go runtime(用户态) | 操作系统内核 |
| 创建数量 | 十万~百万级 | 千级就吃紧 |
| 通信方式 | channel(推荐) | 共享内存 + 锁 |
| 抢占 | 信号异步抢占(1.14+) | 时间片轮转 |
高频追问
- 「一个 goroutine 死循环会怎样?」:1.14 之前会永久占用 P(
GOMAXPROCS=1时整个程序卡死);1.14 之后 sysmon 会发信号抢占,其他 goroutine 仍能运行。 - 「channel 阻塞时 M 在干什么?」:G 进入
_Gwaiting并从 P 上摘下,M 继续执行 P 队列里的其他 G;如果没有其他 G,P 被其他 M 偷走或进入休眠。 - 「goroutine 泄漏怎么排查?」:
runtime.NumGoroutine()观察趋势 →pprof的 goroutine profile 看堆栈聚合 → 定位到具体阻塞点(channel / lock / IO)。 - 「如何限制并发数?」:带缓冲的 channel 做信号量、worker pool、
errgroup.SetLimit、golang.org/x/time/rate限速。 - 「
go func()里循环变量为什么都是最后一个值?」:Go 1.22 之前for循环变量是复用的同一个变量,闭包捕获的是它;Go 1.22 起每轮迭代创建新变量,这个问题自动消失(但显式传参仍是好习惯,兼容旧版本)。
高频陷阱速查
nil 的七种表现
| 类型 | nil 时的行为 |
|---|---|
| nil slice | len/cap 为 0,可以 append、可以 range、可以截取,返回 nil |
| nil map | 可以读(返回零值)、可以 len、可以 range,写入 panic |
| nil channel | 发送/接收都永久阻塞,select 中可用来「关闭某个分支」 |
| nil 指针 | 可以调用指针接收者方法(方法内不能解引用),调用值方法会 panic |
| nil interface | == nil 为 true;但「装了 nil 指针的接口」不等于 nil(typed nil) |
| nil 函数 | 调用直接 panic,只能和 nil 比较 |
| nil 数组指针 | len/cap 仍返回类型长度,range 只迭代索引可用,取元素会 panic |
常见「看起来没问题」的坑
| 写法 | 问题 | 正确做法 |
|---|---|---|
for _, v := range s { v.Field = 1 } | v 是副本,改它不影响原切片 | 用下标 s[i].Field = 1 |
for _, v := range s { p = append(p, &v) } | 1.22 前所有指针指向同一个变量 | Go 1.22+ 已修复;旧版本用 v := v |
s2 := s1[:2]; append(s2, x) | 未扩容时覆盖 s1[2] | 三索引 s1[:2:2] 或 slices.Clone |
m[k].Field = 1(value 是 struct) | map 元素不可寻址,编译失败 | 整体赋值或 map[K]*V |
sync.Mutex 作为函数参数 | 拷贝出一把新锁,锁失效 | 传 *sync.Mutex |
wg.Add(1) 写在 goroutine 里 | 可能 Wait 已返回 | 在 go 之前 Add |
defer f(x) 中 x 后续被修改 | defer 注册时参数已求值 | 用闭包 defer func(){ f(x) }() |
time.After 放在 for 循环 | 定时器堆积、内存涨 | time.NewTimer + Reset |
err != nil 判断 typed nil | 接口非 nil,逻辑误判 | 返回 nil 而不是 (*T)(nil) |
字符串大量 += | 每次都分配新字符串 | strings.Builder |
float64 用 == 比较 | 精度误差 | 比较差值绝对值 < epsilon |
int 与 int64 混用 | 编译错误(无隐式转换) | 显式 int64(x) |
深浅拷贝
- 赋值/传参:数组、结构体是值拷贝(深拷贝到第一层);切片、map、channel、指针、接口拷贝的是「头部结构」,底层数据仍共享(浅拷贝);
- 结构体里的指针字段、slice 字段,拷贝后仍指向同一份数据,需要深拷贝时手动递归复制或用序列化(JSON/gob);
copy(dst, src)只复制元素值,元素本身是指针时仍共享。
版本演进(面试加分项)
| 版本 | 关键变化 |
|---|---|
| 1.5 | 并发三色标记 GC(STW 从秒级降到毫秒级) |
| 1.8 | 混合写屏障,STW 降到亚毫秒;sort.Slice |
| 1.9 | sync.Map、类型别名 type A = B |
| 1.11 | Go Modules |
| 1.13 | errors.Is/As、%w 包装错误;defer 栈上分配 |
| 1.14 | 异步抢占(解决死循环无法抢占);defer 开放编码(性能提升约 30%) |
| 1.16 | embed 嵌入静态文件;io.ReadAll 取代 ioutil |
| 1.18 | 泛型、工作区模式、模糊测试;切片扩容规则改为 256 拐点 |
| 1.19 | GOMEMLIMIT 软内存限制;原子类型 atomic.Int64 |
| 1.21 | 内置 min/max/clear;log/slog;PGO 正式可用 |
| 1.22 | for 循环变量每轮新建;range 支持整数 |
| 1.23 | range 支持迭代器函数;timer 实现优化 |
| 1.24 | map 改用 Swiss Table;泛型类型别名 |
| 1.25 | GOMAXPROCS 默认感知容器 CPU 限制 |
怎么用这份笔记
面试答题的推荐结构:先给结论 → 再讲底层机制 → 最后落到实践(什么场景用、有什么坑)。比如问 map:「map 是哈希桶实现,装载因子超过 6.5 翻倍扩容、溢出桶过多则等量扩容,扩容是渐进式的,所以元素不可寻址;并发写会 fatal,读多写少用 sync.Map」。
只背结论容易被追问穿,能讲清「为什么这样设计」才是区分度所在。
本文作者:枣子
本文链接:
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!